前回は、Articul8が扱う Knowledge Graph について説明しました。企業の知識は文章だけで構成されているわけではなく、元となる文書の構造、文章が持つ意味、製品・部品・顧客・規格などの関係、そしてそれぞれの情報がどの文書を根拠としているのか——こうした異なる種類の情報を一体として扱います。
しかし、PDF・Word・PowerPoint・画像・表などのファイルを取り込んだだけでは、AIがその内容を十分に活用できるとは限りません。100ページの設計資料を一つの大きな文章として扱うと、必要な情報が何ページのどこに書かれているのかを特定しづらくなります。また、文章に登場する製品名・部品名・企業名・規格・事実関係を整理しなければ、情報同士の関係もたどれません。
そこでArticul8では、文書を取り込むことで Knowledge Graph が構築され、その中に複数の種類のノードが作られます。代表的なものが次の要素です。
- Document・Page・Block:元の文書とその構造
- Entity・Claim:文書から理解・抽出された知識
- Question:取り込んだ内容を見つけるための補助情報
- Cluster:関連する知識をグループとして整理したもの
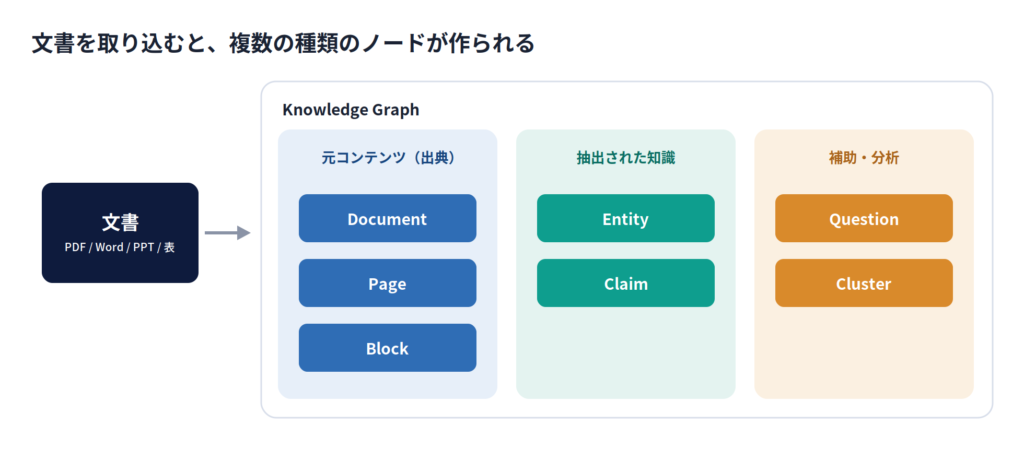
図3-1|取り込みによって、役割の異なる複数のノードが構築される
本記事では代表的な7種にしぼって説明します。このほかにも、規格・標準番号を表す Standard(例:ISO 9001)、取り込み単位を表す PerceptionSession、取り込み後の分析レポートである PerceptionReport といったノードもあります。
Document:知識の出発点となる文書
Document は、Knowledge Graph へ取り込まれたファイルそのものを表します。製品マニュアル、設計仕様書、就業規則、契約書、障害報告書、保守記録、議事録、技術標準、PowerPoint資料などが Document になります。
例えばAIが「Motor M1の最大動作温度は80度です」と回答したとき、回答だけを見ても、その内容がどこに書かれているのかは分かりません。元となる Document を確認できれば、どの仕様書に記載されているのか、最新版か、正式な文書か、確認するにはどこへ戻ればよいかを判断できます。企業向けAIでは、回答内容だけでなく、その情報がどこから来たのかを追跡できることが重要です。Document はそのための最上位の情報単位です。
Page:文書内の場所を示す
Page は、一つの Document をページ単位で表したものです。100ページの製品マニュアルには、それぞれのページに対応する Page が存在します。Document 全体だけでは根拠が文書内のどこにあるかを具体的に示せませんが、Page が管理されることで「この情報は製品マニュアルの12ページに記載されています」という形で確認場所を絞れます。同じ文書でもページごとに内容は異なるため、Page 単位で扱うことで、より細かな粒度で関連情報を特定できます。
Block:ページ内のコンテンツ単位
一つのページにも、見出し・説明文・箇条書き・表・図・図の説明・注意事項など、複数の種類の情報が含まれます。Block は、ページに含まれる個別のコンテンツ単位を表します。文章の段落、セクション、図のキャプションなどが Block として扱われます。
例えばマニュアルの12ページに「製品の概要」「部品の交換手順」「作業時の注意事項」が含まれる場合、それぞれを異なる Block として管理できます。利用者が「交換作業で注意することは?」と質問すれば、ページ全体ではなく、注意事項が書かれた Block を回答の根拠にできます。
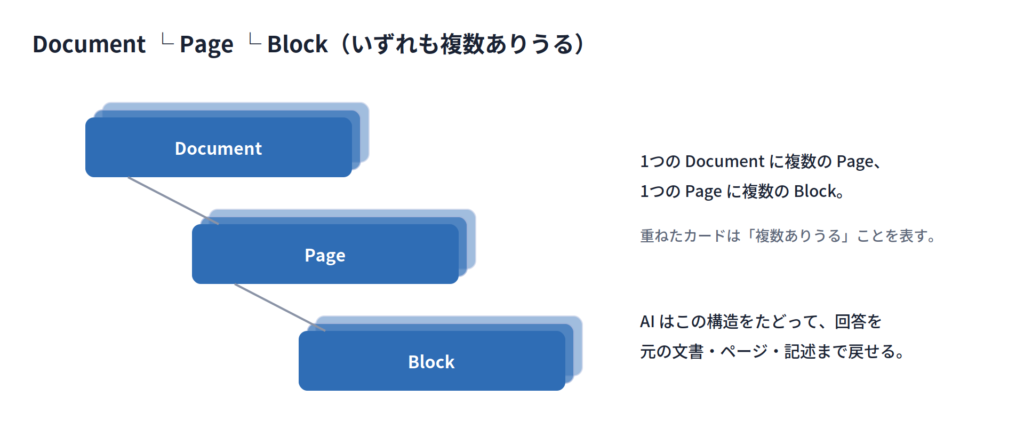
図3-2|Document・Page・Block はいずれも複数ありうる
この構造によって、AIが利用した情報を、元の文書・ページ・コンテンツまでたどることができます。
Entity:文書に登場する対象
企業文書にはさまざまな対象が登場します。製造業の文書なら、製品・部品・装置・工場・顧客・企業・担当者・規格・材料・障害・作業工程などです。Knowledge Graph では、このような名前を持つ対象を Entity(実体・対象)として扱います。
例えば「Motor M1はProduct Aに使用されています」には Motor M1 と Product A、「Product AはCustomer Xへ納入されました」には Product A と Customer X という Entity が登場します。Product A が両方に含まれるため、これらの情報を関係のある知識として結び付けられます。
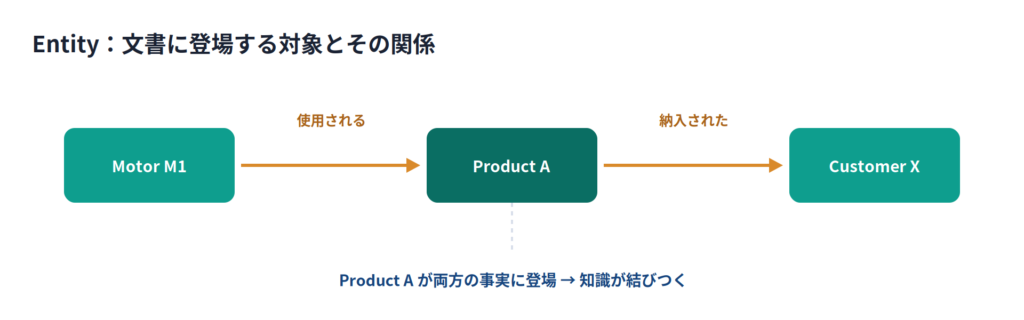
図3-3|同じ Entity を介して、別々の文書の知識がつながる
Entity を使うことで、AIは文書を単なる文字列としてではなく、「何について書かれた情報なのか」という視点から扱えるようになります。なお、同じ対象が「ABC株式会社」「ABC社」「ABC Corporation」のように異なる表記で記載されることもあります。この表記の揺れをどう扱うかは重要な課題ですが、処理方法は製品や構成によって異なるため、本記事では詳細には踏み込みません。
Claim:文書から抽出された事実
Entity が「対象」を表すのに対し、Claim は文書から抽出された構造化された事実を表します。Articul8 における Claim は Subject → Predicate → Object(主語 → 関係・動作 → 目的語)の3要素で表されます。
「Motor M1はProduct Aに使用されています」という文章は、Motor M1 → 使用される → Product A という Claim として表現できます。同様に、Product A → 納入された → Customer X、Motor M1 → 準拠する → Standard S1、Failure F1 → 発生した → Factory Z といった形で、文章に含まれる事実を構造化できます。
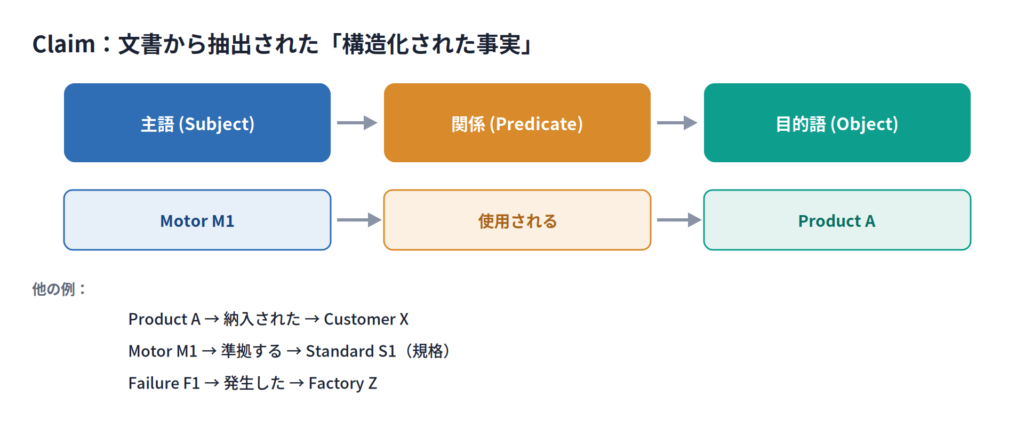
図3-4|事実を「主語・関係・目的語」の3つ組にする
Claim を使うと、AIは文書全体を読むだけでなく、そこに含まれる事実を明確な関係として扱えます。また、複数の Claim を関係に沿ってたどることで、一つの文章には直接書かれていない情報を確認できる場合があります。Motor M1 → 使用される → Product A と Product A → 納入された → Customer X をたどれば、Motor M1 と Customer X の間に Product A を介したつながりがあると分かります。これは新しい事実を作り出しているのではなく、既存の知識を組み合わせて確認しているのです。
Claimと元文書の関係
Claim は特に重要な情報ですが、単独で存在していると、その事実が本当に正しいのかを確認できません。そのため、Claim から元となった Page や Block へ戻れることが重要です。Motor M1 → 最大動作温度 → 80度 という Claim があれば、それがどの Document のどの Page、どの Block に基づいているのかを確認でき、利用者は元の記述を直接確かめられます。
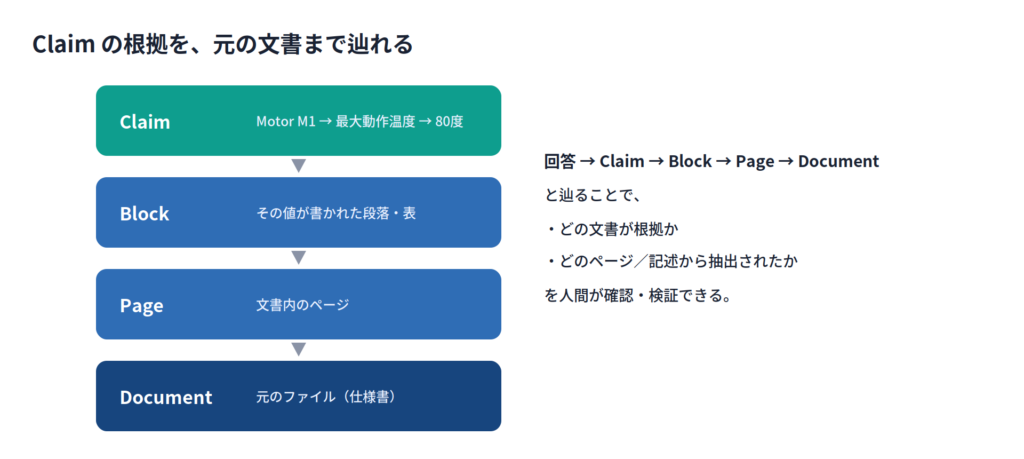
図3-5|Claim → Block → Page → Document とたどって根拠を確認できる
企業向けAIでは、単に回答を生成するだけでなく、回答の根拠を確認できることが重要です。Claim と元の Document 構造がつながっていることで、AIの回答を人間が検証しやすくなります。
Question:文書内容を見つけるための補助情報
Question は、文書の取り込み時に生成される質問です。取り込まれた内容をもとに合成された質問であり、Knowledge Graph 内の情報を見つけるためのヒントとして使えます。「Motor M1の最大動作温度は80度です」と書かれていれば、「Motor M1の最大動作温度は何度ですか。」といった Question が作られる可能性があります。
ただし Question そのものは、元文書から直接抽出された事実ではありません。AIによって合成された質問であるため、権威のある根拠として扱うべきではありません。回答を確認する際は、Question ではなく Claim・Page・Block などの元情報を優先します。Question は、Knowledge Graph の内容へアクセスしやすくするための「案内役」と考えると分かりやすいでしょう。
Cluster:関連する知識のまとまり
文書を大量に取り込むと、多くの Document・Page・Block・Entity・Claim が構築されます。情報量が増えるほど、その中にどんなテーマや知識領域があるのかを把握しづらくなります。Cluster は、意味的または関係的に近いノードを、クラスタリングアルゴリズムによってグループ化したものです。
例えば大量の製造関連文書を取り込むと、「モーターの障害」「製品安全規格」「サプライヤーリスク」「保守契約」「工場設備のメンテナンス」といったテーマに関連する情報がまとまる可能性があります(実際の内容や名称は、取り込んだ文書と検出された関係によって異なります)。Cluster はフォルダのように人間があらかじめ決めた分類とは異なり、保存場所やファイル形式が違っても、内容や関係が近ければ同じ Cluster に含まれることがあります。
Cluster は、Knowledge Graph にどんなテーマが含まれているかを把握するのに役立ちます。ただし元文書に直接書かれた事実そのものではなく、関連するノードを分析によってまとめた、整理・分析のための情報です。
VectorとGraphはどのように働くのか
これらの情報は、Vector による意味検索と、Graph による関係探索の両方で活用されます。例えば「モーターが高温になった過去の事例を教えてください」と質問したとします。Vector による意味検索では「高温」だけでなく、過熱・温度上昇・熱異常・オーバーヒートなど、意味の近い表現を含む情報を見つけられます。これにより、質問に関連する Block や Claim を探せます。
さらに Graph によって、その情報に関係する Entity や Claim をたどります。Failure F1 → 発生部品 → Motor M1、Motor M1 → 使用される → Product A、Product A → 納入された → Customer X という関係をたどれば、どの部品で障害が発生し、その部品はどの製品に使われ、その製品はどの顧客へ納入されたのかを確認できます。そして関連する Claim から Block・Page・Document へ戻ることで、元となった情報を確認できます。
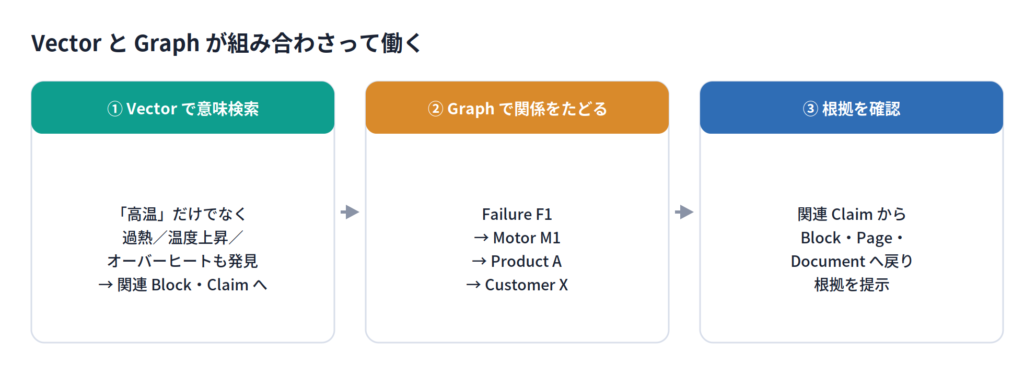
図3-6|意味で見つけ、関係でたどり、根拠で確かめる
文書検索から企業知識の活用へ
従来の文書検索では、利用者が必要な資料を探し、読み、複数の情報を自分で組み合わせる必要がありました。RAG によって、AIが質問に関連する文章を検索し、その内容をもとに回答できるようになりました。そして Knowledge Graph では、文章を探すだけでなく、文書の構造・登場する対象・得られた事実・情報同士の関係を一体として扱います。
Document・Page・Block で元の情報の場所を確認でき、Entity で何について書かれているかを扱え、Claim で事実を構造化でき、Question で情報へのヒントを作れ、Cluster で関連テーマを把握できます。これらが Vector と Graph によって結び付けられることで、社内に蓄積された文書は、単に検索されるファイルではなく、AIが意味を探し・関係をたどり・根拠を確認できる「企業知識」として活用されます。
Knowledge Graph の価値は、情報をネットワーク図として表示することだけではありません。企業内に散在する文書と知識を結び付け、AIと人間がより正確に利用できる形へ変えることにあります。この基盤が整うことで、AIは一つの質問へ回答するだけでなく、複数の情報を調査・比較し、関係を確認しながら、より複雑な業務を支援できるようになります。
NEXT
その次の段階で重要になるのが、AI Agent という考え方です。